Was genau ist ein Small Language Model?
Ein SLM ist ein Sprachmodell, das auf derselben Transformer-Architektur beruht wie seine größeren Gegenstücke, aber deutlich kleiner ausfällt. Während große Modelle zehn bis hundert Milliarden Parameter und mehr enthalten können, liegen SLMs typischerweise zwischen einigen hundert Millionen und rund zehn Milliarden Parametern.
Die Komprimierung des Modells gelingt mit mehreren Techniken. Pruning entfernt weniger wichtige Neuronen oder Gewichte, die nur minimalen Einfluss auf die Ausgabe haben. Quantisierung wandelt präzise 32-Bit-Gleitkommawerte in Formate mit geringerer Genauigkeit um, etwa in 16-Bit- oder 8-Bit-Darstellungen. Das senkt den Speicherbedarf und verbessert zugleich die Effizienz der Inferenz. Knowledge Distillation überträgt das Verhalten und die Entscheidungsmuster eines großen „Lehrermodells“ auf ein kleineres „Schülermodell“. So behält das kleinere Modell einen Großteil der ursprünglichen Fähigkeiten und kommt dabei mit weniger Ressourcen aus.
Die meisten heutigen SLMs entstehen durch eine Kombination dieser Ansätze.
TinyML verarbeitet Signale. SLMs verarbeiten Sprache.
TinyML bezeichnet Machine-Learning-Modelle, die klein genug sind, um auf Mikrocontrollern zu laufen. Typisch sind Größen von einigen zehn bis hundert Kilobyte, oft auf einer MCU ganz ohne Betriebssystem und mit einer Leistungsaufnahme im Milliwattbereich. Die Modelle sind meist kompakte neuronale Netze oder klassische Klassifikatoren, trainiert für eine eng definierte Aufgabe: eine Anomalie im Schwingungsspektrum detektieren, ein Schlüsselwort erkennen, ein Bewegungsmuster klassifizieren, einen Lagerschaden vorhersagen. Die Eingabe sind numerische Sensordaten. Die Ausgabe ist eine Klasse, ein Score oder eine Schwellwertüberschreitung.
Ein SLM bewegt sich in einer völlig anderen Größenordnung. Es braucht einen Applikationsprozessor mit mehreren hundert Megabyte bis einigen Gigabyte RAM, ein vollwertiges Betriebssystem und für einen akzeptablen Durchsatz meist eine NPU oder eine Embedded-GPU. Dafür bewältigt es, was TinyML nicht kann: Sprache, die interpretiert und nicht klassifiziert werden muss, und eine Ausgabe, die erzeugt und nicht ausgewählt wird.
| TinyML | SLM | |
|---|---|---|
| Typische Modellgröße | Kilobyte bis wenige Megabyte | Mehrere hundert MB bis einige GB |
| Zielhardware | MCU (Cortex-M-Klasse), kein Betriebssystem nötig | Applikationsprozessor, NPU, Embedded-Linux |
| Leistungsbedarf | Milliwatt, jahrelanger Batteriebetrieb möglich | Watt, erfordert ein echtes Energiebudget |
| Eingangsdaten | Numerische Sensordatenströme | Text, Logs, transkribierte Sprache, strukturierte Dokumente |
| Aufgabenumfang | Eine feste, vordefinierte Aufgabe | Flexibel, bewältigt auch Aufgaben, für die es nicht ausdrücklich trainiert wurde |
| Typische Ausgabe | Klasse, Score, Schwellwertereignis | Text, Zusammenfassung, strukturierte Extraktion, Anweisung |
Wenn TinyML ausreicht, nutzen Sie TinyML.
Wenn die Aufgabe darin besteht, ein bekanntes Signalmuster einer definierten Menge von Ergebnissen zuzuordnen, ist ein SLM das falsche Werkzeug. Es verbraucht um Größenordnungen mehr Energie, verlangt deutlich leistungsfähigere Hardware und bringt keinen Vorteil. Ein Detektor für Schwingungsanomalien, der mit wenigen hundert Kilobyte auf einem Cortex-M4 läuft, ist kein Kompromiss, sondern die richtige technische Antwort.
Wenn TinyML nicht ausreicht.
Die Eingabe ist Sprache, kein Signal.
Wartungsprotokolle, Notizen der Bediener, Serviceberichte, Fehlermeldungen und Spracheingaben sind Text. TinyML hat keinen Mechanismus, um sie zu interpretieren.
Die Aufgabe ist offen.
TinyML-Modelle werden für einen festen Ausgaberaum trainiert. Soll das System Fragen beantworten, für die es nie ausdrücklich trainiert wurde, oder eine Zusammenfassung erzeugen statt ein Label auszuwählen, reicht die TinyML-Architektur nicht so weit.
Das System muss Sprache nicht nur aufnehmen, sondern auch erzeugen.
Einem Techniker einen Fehler zu erklären, einen strukturierten Störungsbericht zu erzeugen oder auf eine gesprochene Anfrage zu antworten, setzt Generierung voraus. Das liegt außerhalb dessen, was TinyML leisten kann.
In der Praxis ergänzen sich beide eher, als dass sie sich ausschließen.
Die nützlichste Architektur, die uns begegnet, ist geschichtet: TinyML am Sensor, im Dauerbetrieb mit minimaler Leistungsaufnahme, erkennt, dass sich etwas verändert hat. Eine Ebene darüber interpretiert ein SLM auf dem Gateway oder dem Edge-Controller, was dieses Ereignis im Kontext bedeutet, verknüpft es mit der Wartungshistorie und beschreibt es in einer Sprache, mit der ein Mensch weiterarbeiten kann.
Die TinyML-Ebene entscheidet, dass etwas passiert ist. Die SLM-Ebene hilft zu erklären, was es bedeutet.
Was ist ein System on Chip (SoC)?
Ein SoC bestimmt das Design von Embedded-Hardware: CPU- und Echtzeit-Cores, die NPU für die KI-Inferenz direkt auf dem Gerät, thermische und energetische Einschränkungen sowie die langfristige Verfügbarkeit.
Ingenieur mit Tablet in einer Produktionshalle, einer Umgebung, in der Cloud-KI oft an ihre Grenzen stößt.
Warum sind SLMs für Embedded- und Industrieanwendungen relevant?
Embedded Machine Learning hat sich bis vor Kurzem fast ausschließlich um numerische Sensordaten gedreht, und für diese Ebene bleibt TinyML das richtige Werkzeug. SLMs kommen mit der Fähigkeit hinzu, Sprache auf begrenzter Hardware zu verarbeiten. Das öffnet eine Kategorie von Aufgaben, die Embedded-Systeme bisher an einen Server senden mussten. Genau hier zeigen sich die praktischen Vorteile. Cloudbasierte LLMs sind für viele industrielle Szenarien ungeeignet, nicht wegen der Qualität der Ausgabe, sondern wegen der physikalischen, betrieblichen und regulatorischen Randbedingungen der jeweiligen Umgebung.
Latenz
Cloud-Inferenz dauert typischerweise einige zehn bis mehrere hundert Millisekunden. Für Systeme, die Maschinenschwingungen, Sprachbefehle oder sicherheitskritische Sensordaten in Echtzeit verarbeiten, sind solche Verzögerungen nicht akzeptabel.
Ein SLM, das direkt auf einem SoC läuft (etwa auf der Zynq-Plattform oder auf NXP i.MX), kann die Antwortzeiten bei bestimmten Workloads von mehreren hundert Millisekunden auf einen Betrieb nahe der Echtzeit senken.
Sicherheit und Datenschutz
In medizinischen Anwendungen oder bei kritischer Infrastruktur dürfen Daten das lokale Netz oft nicht verlassen. Ein SLM direkt im Gerät löst dieses Problem physisch, denn Rohdaten werden gar nicht erst übertragen.
Dieser Ansatz kann außerdem die Compliance mit Normen wie IEC 62443 und ISO 13485 unterstützen, weil er die Datenexposition verringert und die gesamte Sicherheitsarchitektur vereinfacht.
Energieverbrauch
Auch Cloud-Inferenz hat ihren Energiepreis. Geräte mit Batteriebetrieb oder Energy Harvesting können keine dauerhafte Verbindung halten und nicht ununterbrochen Daten zur entfernten Verarbeitung senden.
Ein SLM arbeitet lokal weiter, auch wenn die Kommunikationsschnittstellen im Energiesparmodus sind, und aktiviert die externe Verbindung nur dann, wenn sie wirklich gebraucht wird.
Bei den Größenordnungen lohnt sich Genauigkeit. Ein SLM ist drastisch effizienter als der Weg in die Cloud und zurück, aber in absoluten Zahlen ist es keine stromsparende Technologie. Im Dauerbetrieb braucht es ein Energiebudget im Wattbereich. Für Geräte, die von einer Knopfzelle oder aus Energy Harvesting versorgt werden, bleibt TinyML die einzige gangbare Option. Das SLM gehört eine Ebene höher in der Architektur, auf einen netzbetriebenen Knoten oder einen Knoten mit größerer Batterie.
Offline-Betrieb
Industrieumgebungen, Netze der Rettungsdienste, maritime Systeme und abgelegene Installationen können sich nicht immer auf eine durchgehende Internetverbindung verlassen, selbst wenn Satellitenkommunikation verfügbar ist.
SLMs arbeiten auch ohne Netzverbindung weiter, ähnlich wie eine TETRA-Basisstation unabhängig von einem kommerziellen Mobilfunknetz funktionieren kann.
Miniaturfiguren arbeiten an einer Leiterplatte, als Bild für das Fine-Tuning eines Modells auf ein bestimmtes System.
Welche Modelle gibt es heute?
Das Feld der SLMs entwickelt sich schnell. Aus Sicht des Einsatzes auf Edge-Hardware sind aber einige Modelle besonders erwähnenswert.
Phi von Microsoft (3,8 Milliarden Parameter) ist für Umgebungen mit begrenzten Ressourcen ausgelegt und über Azure AI Studio und Hugging Face verfügbar.
Llama 3.2 von Meta bietet Varianten mit 1 und 3 Milliarden Parametern, darunter quantisierte Versionen, die den Speicherbedarf senken und zugleich die Inferenzleistung verbessern.
Granite von IBM gibt es in Varianten mit 1 und 3 Milliarden Parametern und ist auf niedrige Inferenzlatenz optimiert.
Wichtig ist: Diese Modelle können nur selten genau so eingesetzt werden, wie sie ausgeliefert werden. Ein Fine-Tuning auf domänenspezifische Daten, etwa auf das Vokabular, die Betriebsbedingungen und die Arbeitsabläufe einer bestimmten Industrieanlage, kann die Leistung deutlich verbessern und das Modell dabei weit kleiner halten als ein universelles LLM.
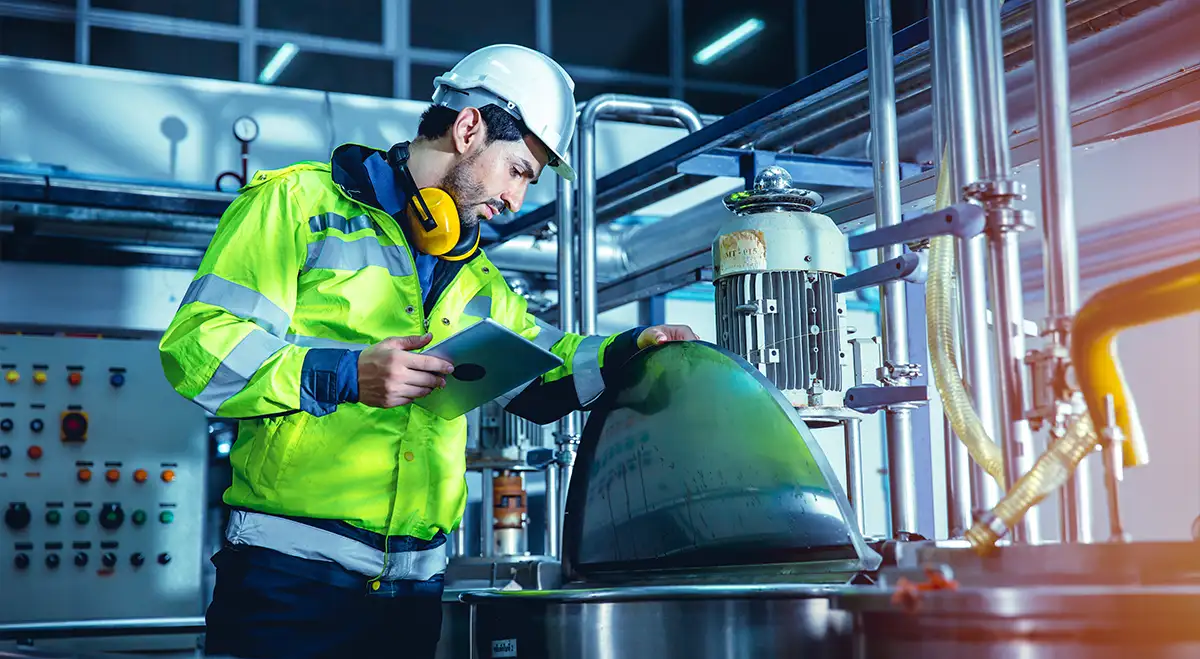
Techniker mit Tablet an einer Industriemaschine. Ein SLM kann ihm eine erkannte Anomalie in verständlicher Sprache erklären.
Wo macht das Sinn und wo nicht?
SLMs sind keine universelle Lösung, und das sollte man offen sagen.
Für Aufgaben, die breites Allgemeinwissen, komplexes Schlussfolgern über mehrere Domänen hinweg oder sehr große Kontextfenster verlangen, bleiben größere Modelle die bessere Wahl. SLMs spielen ihre Stärken dort aus, wo die Aufgabe klar definiert und eingegrenzt ist.
Vorausschauende Wartung zeigt diese Aufteilung gut.
Die Erkennung selbst gehört zu TinyML: Ein Schwingungssensor wertet FFT-Muster lokal aus und markiert Anomalien, ohne Rohsignale in die Cloud zu streamen, und läuft dabei mit minimaler Leistungsaufnahme direkt an der Maschine.
Der Nutzen des SLM liegt in der Ebene darüber. Sobald eine Anomalie markiert ist, sind die hilfreichen Fragen sprachlich und nicht mehr numerisch: Ist dieses Muster in der Wartungshistorie dieser Maschine schon einmal aufgetreten, was hat der Techniker beim letzten Mal in den Servicebericht geschrieben, und wie sollte das Ereignis dem Bediener in der Schicht beschrieben werden? Das ist Textinterpretation auf unstrukturierten, anlagenspezifischen Daten. Genau das kann TinyML nicht und ein SLM schon, ohne interne Wartungsdaten an einen externen Dienst zu senden.
Dasselbe Architekturmuster, also kontinuierlicher Sensoreingang, lokale Klassifikation und selektive Kommunikation, ist in vielen Anwendungen die Grundlage von Embedded Machine Learning.
Dasselbe Muster zeigt sich in unseren eigenen Projekten.
Bei Consilia haben wir ähnliche Ansätze in mehreren Bereichen umgesetzt. Im Projekt Smart Headphones for Personal Safety entscheidet die Signalverarbeitung im Gerät in Echtzeit, ob der Umgebungslärm ein potenziell schädliches Niveau erreicht hat. Im Projekt Smart Data Collecting Badge werden mehrere Eingänge eines Wearables lokal zusammengeführt und klassifiziert, um Gefahrenzustände für den Mitarbeiter zu erkennen.
In all diesen Fällen gilt dasselbe technische Prinzip wie bei der Auswahl eines SoC oder RTOS: das kleinste und effizienteste Werkzeug wählen, das die Anforderungen der jeweiligen Aufgabe erfüllt.
Was ist ein Edge Gateway?
Das Edge-Gateway verbindet nicht nur Geräte. Es wertet Daten aus, führt lokale Logik aus und entscheidet, welche Daten in die Cloud gelangen.
Miniaturfiguren arbeiten gemeinsam an einer Leiterplatte. Ein Modell einzusetzen, verlangt abgestimmte Hardware- und Softwarearbeit.
Erwägen Sie KI-Inferenz auf Ihrer Hardware?
Ein Sprachmodell in ein Embedded- oder Industriesystem zu integrieren, ist nicht nur eine Softwarefrage. Es ist eine anspruchsvolle Aufgabe, die die gesamte Systemarchitektur betrifft. Die Entscheidung, KI lokal auszuführen, wirkt sich auf jede Ebene aus: von der Auswahl des SoC über den Speicherbedarf bis zu Energiebudget, thermischem Design und der Optimierung des Software-Stacks.
Bei Consilia entwerfen wir Embedded-Systeme so, dass diese spezifischen Einschränkungen bereits auf Architekturebene und nicht erst nachträglich berücksichtigt werden. Ein Modell auszuwählen, zu komprimieren und in Betrieb zu nehmen, verlangt abgestimmte Arbeit über Hardware- und Softwaredisziplinen hinweg.
Wenn Sie überlegen, ob lokale KI-Inferenz für Ihr Produkt sinnvoll ist, sprechen Sie uns an. Wir besprechen gerne die technischen Gegebenheiten, bewerten die nötigen Kompromisse und helfen Ihnen zu entscheiden, ob eine lokale Lösung die beste Wahl ist.
Fallstudien
Zusammenhängende Projekte

Intelligente Kopfhörer für die persönliche Sicherheit
Beim Hardwaredesign konzentrierten wir uns auf Skalierbarkeit und Stromverbrauch (Gleichgewicht zwischen Akkulaufzeit und Rechenleistung). — Fallstudie

Smart Badge zur Datenerfassung
Wir entwarfen ein Gerät in der Größe eines etwas dickeren Personalausweises und statteten dieses mit der gesamten Elektronik aus.
Basisstation für TETRA-Netz
Consilia hat die gesamte TETRA-Basisstation entwickelt. Die Leistungseffizienz unserer Lösung stellt das Produkt in die Spitzengruppe der Konkurrenzprodukte.