Co přesně je Small Language Model?
SLM je jazykový model postavený na stejné transformer architektuře jako jeho větší protějšky, ale výrazně zmenšený. Zatímco velké modely mohou pracovat s desítkami až stovkami miliard parametrů, SLM se obvykle pohybují od stovek milionů zhruba po deset miliard parametrů.
Komprese modelu se dosahuje několika technikami. Prořezávání (pruning) odstraňuje méně důležité neurony nebo váhy, které mají na výstup minimální vliv. Kvantizace (quantization) převádí přesné 32bitové hodnoty s plovoucí řádovou čárkou na formáty s nižší přesností, například 16bitové nebo 8bitové, čímž snižuje paměťové nároky a zároveň zvyšuje efektivitu inference. Destilace znalostí (knowledge distillation) přenáší chování a rozhodovací vzorce velkého modelu „učitele“ na menší model „studenta“, díky čemuž si menší model zachová většinu původních schopností, ale pracuje s méně prostředky.
Většina dnešních SLM vzniká kombinací těchto přístupů.
TinyML zpracovává signály. SLM zpracovává jazyk.
TinyML označuje modely strojového učení natolik malé, že běží na mikrokontrolérech, typicky v desítkách až stovkách kilobajtů, často na MCU zcela bez operačního systému a s odběrem v řádu miliwattů. Bývají to kompaktní neuronové sítě nebo klasické klasifikátory natrénované na jednu úzce definovanou úlohu: detekovat anomálii ve vibračním spektru, rozpoznat klíčové slovo, klasifikovat vzorec pohybu, předpovědět poruchu ložiska. Vstupem jsou číselná data ze senzorů. Výstupem je třída, skóre nebo překročení prahu.
SLM funguje v úplně jiném režimu. Vyžaduje aplikační procesor se stovkami megabajtů až jednotkami gigabajtů RAM, plnohodnotný operační systém a pro přijatelnou propustnost obvykle NPU nebo embedded GPU. Na oplátku zvládne to, co TinyML neumí: jazyk, který je potřeba interpretovat, ne klasifikovat, a výstup, který se generuje, ne vybírá.
| TinyML | SLM | |
|---|---|---|
| Typická velikost modelu | Kilobajty až jednotky megabajtů | Stovky MB až jednotky GB |
| Cílový hardware | MCU (třída Cortex-M), bez operačního systému | Aplikační procesor, NPU, embedded Linux |
| Energetická náročnost | Miliwatty, provoz na baterii i roky | Watty, vyžaduje reálný energetický rozpočet |
| Vstupní data | Číselné toky dat ze senzorů | Text, logy, přepsaná řeč, strukturované dokumenty |
| Rozsah úlohy | Jedna pevně daná, předem definovaná úloha | Flexibilní, zvládne i úlohy, na které nebyl výslovně trénován |
| Typický výstup | Třída, skóre, událost překročení prahu | Text, shrnutí, strukturovaná extrakce, instrukce |
Když stačí TinyML, použijte TinyML.
Pokud je úlohou klasifikovat známý vzorec signálu proti definované množině výsledků, je SLM špatný nástroj. Spotřebuje řádově víc energie, vyžádá si mnohem výkonnější hardware a nepřinese žádný užitek. Detektor vibračních anomálií, který běží v několika stovkách kilobajtů na Cortex-M4, není kompromis, ale správná inženýrská odpověď.
Když TinyML nestačí.
Vstupem je jazyk, ne signál.
Záznamy o údržbě, poznámky operátorů, servisní zprávy, chybové hlášky a hlasový vstup jsou text. TinyML nemá čím je interpretovat.
Úloha je otevřená.
Modely TinyML se trénují na pevně daný prostor výstupů. Pokud má systém odpovídat na otázky, na které nebyl výslovně trénován, nebo místo výběru štítku vygenerovat shrnutí, architektura TinyML tak daleko nesahá.
Systém musí jazyk nejen přijímat, ale i vytvářet.
Vysvětlit technikovi poruchu, vygenerovat strukturovaný protokol o incidentu nebo odpovědět na mluvený dotaz vyžaduje generování, které je mimo možnosti TinyML.
V praxi se oba přístupy spíš doplňují, než vylučují.
Nejužitečnější architektura, se kterou se setkáváme, je vrstvená: TinyML u senzoru běží nepřetržitě s minimální spotřebou a detekuje, že se něco změnilo. O vrstvu výš SLM na gateway nebo edge kontroléru interpretuje, co daná událost v kontextu znamená, propojuje ji s historií údržby a sděluje ji jazykem, se kterým člověk může dál pracovat.
Vrstva TinyML rozhodne, že se něco stalo. Vrstva SLM pomůže vysvětlit, co to znamená.
Co je System on Chip (SoC)?
SoC určuje návrh embedded hardwaru: CPU a real-time jádra, NPU pro AI inferenci přímo na zařízení, teplotní a výkonové limity i dlouhodobou dostupnost.
Inženýr s tabletem ve výrobní hale, v prostředí, kde cloudová AI často naráží na své limity.
Proč jsou SLM relevantní pro embedded a průmyslové aplikace?
Embedded machine learning se donedávna točil téměř výhradně kolem číselných dat ze senzorů a pro tuto vrstvu zůstává TinyML správným nástrojem. SLM k tomu přidávají schopnost zpracovat jazyk na omezeném hardwaru, což otevírá kategorii úloh, které dřív musela embedded zařízení posílat na server. A právě tady se ukazují praktické přínosy. Cloudové LLM jsou pro řadu průmyslových scénářů nevhodné. Ne kvůli kvalitě výstupu, ale kvůli fyzickým, provozním a regulatorním omezením daného prostředí.
Latence
Cloudová inference obvykle trvá desítky až stovky milisekund. Pro systémy, které v reálném čase zpracovávají vibrace strojů, hlasové příkazy nebo data ze senzorů kritická pro bezpečnost, jsou taková zpoždění nepřijatelná.
SLM nasazený přímo na SoC (například na platformě Zynq nebo NXP i.MX) dokáže u konkrétních úloh zkrátit dobu odezvy ze stovek milisekund na provoz blízký reálnému času.
Bezpečnost a ochrana dat
Ve zdravotnických aplikacích nebo u kritické infrastruktury data často nesmí opustit lokální síť. Nasazení SLM přímo do zařízení tento problém řeší fyzicky, protože surová data se nikam nepřenášejí.
Tento přístup může také podpořit soulad se standardy jako IEC 62443 a ISO 13485 tím, že snižuje expozici dat a zjednodušuje celkovou bezpečnostní architekturu.
Spotřeba energie
Svou energetickou cenu má i cloudová inference. Zařízení napájená z baterie nebo z energy harvestingu si nemohou dovolit udržovat trvalé připojení a nepřetržitě odesílat data ke vzdálenému zpracování.
SLM dokáže pracovat lokálně i ve chvíli, kdy jsou komunikační rozhraní v úsporném režimu, a externí připojení aktivuje jen tehdy, když je to skutečně nutné.
Je dobré být v otázce měřítka přesný. SLM je řádově úspornější než cesta do cloudu a zpět, ale v absolutních číslech nejde o technologii s nízkou spotřebou. Jeho nepřetržitý provoz vyžaduje energetický rozpočet v řádu wattů. Pro zařízení napájená z knoflíkové baterie nebo z energy harvestingu zůstává jedinou schůdnou možností TinyML a SLM patří o vrstvu výš v architektuře, na uzel napájený ze sítě nebo z větší baterie.
Provoz offline
Průmyslová prostředí, sítě záchranných složek, námořní systémy a vzdálené instalace se nemohou vždy spolehnout na trvalé připojení k internetu, a to ani tam, kde je k dispozici satelitní komunikace.
SLM fungují dál i bez připojení k síti, podobně jako základnová stanice TETRA dokáže fungovat nezávisle na komerční mobilní síti.
Miniaturní figurky upravují desku plošných spojů jako obraz doladění modelu na konkrétní systém.
Jaké modely jsou dnes k dispozici?
Svět SLM se rychle vyvíjí, ale z pohledu nasazení na edge hardware stojí za zmínku několik modelů.
Phi od Microsoftu (3,8 miliardy parametrů) je navržen pro prostředí s omezenými prostředky a je dostupný přes Azure AI Studio a Hugging Face.
Llama 3.2 od Meta nabízí verze s 1 a 3 miliardami parametrů, včetně kvantizovaných verzí, které snižují paměťové nároky a zároveň zlepšují výkon inference.
Granite od IBM je k dispozici ve variantách s 1 a 3 miliardami parametrů a je optimalizovaný pro nízkou latenci inference.
Důležité je, že tyto modely jen zřídka stačí nasadit přesně v podobě, v jaké jsou dodány. Fine-tuning na doménová data (například slovník, provozní podmínky a workflow konkrétního průmyslového systému) může výrazně zlepšit výkon a model přitom udržet mnohem menší než univerzální LLM.
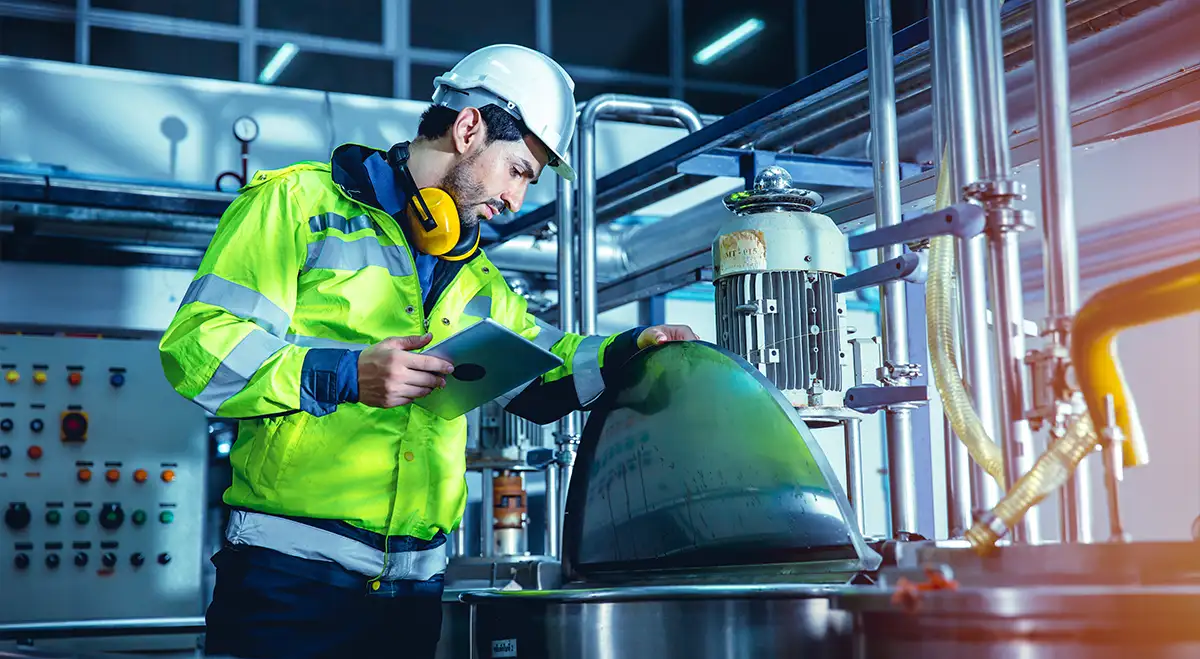
Technik s tabletem u průmyslového stroje. SLM mu může označenou anomálii vysvětlit srozumitelným jazykem.
Kde to dává smysl a kde ne?
SLM nejsou univerzální řešení a je dobré to říct na rovinu.
Pro úlohy, které vyžadují širokou obecnou znalost, složité uvažování napříč více doménami nebo velmi rozsáhlá kontextová okna, zůstávají lepší volbou větší modely. SLM excelují tam, kde je úloha jasně definovaná a ohraničená.
Prediktivní údržba je ukázkovým příkladem.
Samotná detekce patří TinyML: vibrační senzor vyhodnocuje FFT vzorce lokálně a označuje anomálie, aniž by surové průběhy odesílal do cloudu, a běží s minimální spotřebou přímo u stroje.
SLM přidává hodnotu ve vrstvě nad tím. Jakmile je anomálie označená, užitečné otázky přestávají být číselné a stávají se jazykovými: objevil se tento vzorec v historii údržby daného stroje už dřív, co technik naposledy napsal do servisní zprávy a jak událost popsat operátorovi na směně. To je interpretace textu nad nestrukturovanými daty specifickými pro daný provoz. Přesně to TinyML neumí a SLM ano, aniž by se interní záznamy o údržbě odesílaly do externí služby.
Stejný architektonický vzorec (kontinuální vstup ze senzorů, lokální klasifikace a selektivní komunikace) je základem embedded machine learningu napříč mnoha aplikacemi.
Stejný vzorec se objevuje i v našich projektech.
V projektu Smart Headphones for Personal Safety zpracování signálu přímo v zařízení v reálném čase vyhodnocuje, zda okolní hluk dosáhl potenciálně škodlivé úrovně. V projektu Smart Data Collecting Badge se více vstupů z nositelného zařízení agreguje a klasifikuje lokálně, aby bylo možné rozpoznat nebezpečné stavy ohrožující pracovníka.
Ve všech těchto případech platí stejný inženýrský princip jako při výběru SoC nebo RTOS: zvolit nejmenší a nejefektivnější nástroj, který splní požadavky úlohy.
Co je Edge Gateway?
Edge Gateway zařízení nejen připojuje. Vyhodnocuje data, spouští lokální logiku a rozhoduje, co se dostane do cloudu, ještě než lokální síť opustí jediný bajt.
Miniaturní figurky společně pracují na desce plošných spojů. Nasazení modelu vyžaduje koordinovanou práci hardwaru i softwaru.
Zvažujete AI inferenci na svém hardwaru?
Integrace jazykového modelu do embedded nebo průmyslového systému není jen otázkou softwaru, ale je to komplexní výzva pro celou systémovou architekturu. Rozhodnutí provozovat AI lokálně ovlivňuje každou vrstvu: od výběru SoC přes paměťové nároky a energetický rozpočet až po tepelný návrh a optimalizaci softwarového stacku.
V Consilia navrhujeme embedded systémy tak, aby tato specifická omezení řešily už na úrovni architektury, ne až dodatečnými úpravami. Výběr, komprese a nasazení modelu u nás vyžadují koordinovanou práci napříč hardwarovými i softwarovými disciplínami.
Pokud zvažujete, zda lokální AI inference dává pro váš produkt smysl, kontaktujte nás. Rádi s vámi probereme technickou realitu, posoudíme nutné kompromisy a pomůžeme vám určit, zda je lokální řešení tou správnou volbou.
Realizované projekty
Související projekty Consilia

Chytrá sluchátka pro osobní bezpečnost
Při návrhu hardwaru jsme se zaměřili na škálovatelnost a spotřebu energie, abychom umožnili jemnou rovnováhu mezi výdrží baterie a výpočetním výkonem. Čtěte více.

Chytrá ID karta sbírající monitorovací údaje
Vytvořili jsme zařízení o velikosti o něco silnější ID karty a vybavili ho veškerou elektronikou, včetně čipu BLE, LED diod, baterie a nabíjecího obvodu. Čtěte víc
Základnová stanice pro síť TETRA
Vyvinuli jsme celou základnovou stanici TETRA. Vynikající energetická účinnost našeho řešení řadí produkt do nejvyšší úrovně konkurenčních produktů.